模型可以下载,支撑AI普惠的算力、电力与冷却却无法下载
模型可以开放,Token仍在计量,而每一个兆瓦仍然需要被真正建设出来。
The model may be open. The tokens are still metered. And the megawatts still have to be built.
一条超过10万浏览量的评论
黄仁勋在LinkedIn分享《Open Weights and American AI Leadership》后,我认真读完了这封由多家科技公司、投资机构和开源组织共同签署的公开信。
信中最打动我、也最认同的一点,并不是关于开放与封闭的意识形态争论,而是一个非常实际的效率原则:把前沿规模的算力留给真正的前沿问题,让更高效、更专业化的模型运行在其他所有地方。
我在黄仁勋的LinkedIn帖子下面写道:开放权重可以让工厂、医院或农场在自己的基础设施上运行适合任务规模的模型,但“自己的基础设施”仍然需要被供电和冷却。模型民主化解决了主权中“软件”的那一半;让支撑模型的每一瓦电力都发挥价值,才是由物理世界决定的另一半。
不到24小时,这条评论获得了超过104,000次浏览、66个互动和21条回复。一条LinkedIn评论当然不能证明一个行业结论,但它是一个信号:开放模型、算力效率和AI基础设施,正在触及越来越多人的真实焦虑。
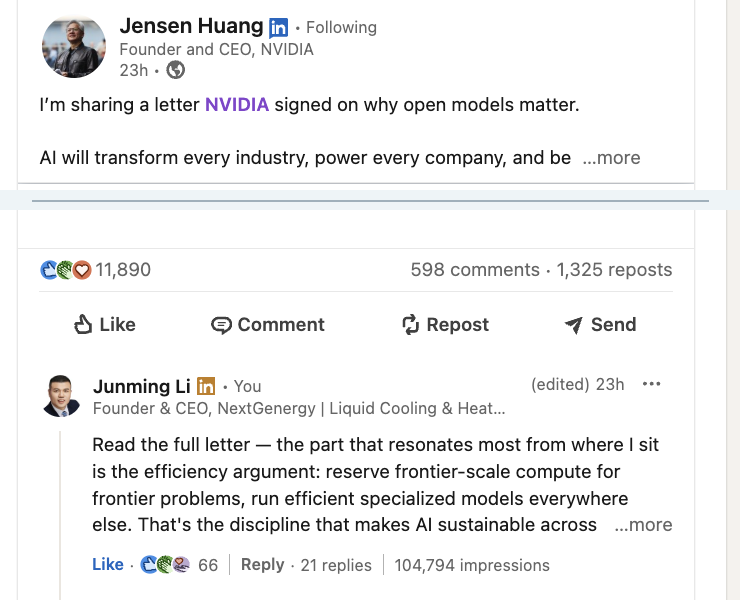
图1|黄仁勋发布开放权重联署信后,作者评论在不到24小时内获得104,794次浏览。
如果开放权重正在让先进模型变得更容易获得,为什么使用AI仍然如此昂贵?
25年IT经历:我看到“开放”如何改变技术
从2001年进入IT行业以来,我亲历了开放架构、开源软件和云原生技术如何扩大技术生态;最近八年多聚焦在高密度算力中心基础设施领域。
回头看,技术并非只有开放才能成功。封闭体系同样能够创造优秀产品、强大平台和卓越体验。但有一个反复出现的规律:当一项技术需要走出一家公司、形成广泛生态并进入千行百业时,开放标准、开放接口和开放实现往往会成为重要加速器。
1981年推出的IBM PC采用相对开放的架构,使用现成组件,并发布技术参考资料,让其他公司能够开发兼容的软件和外设。1993年,CERN将万维网核心软件置于公共领域,随后又以开放许可证发布,让Web从实验室项目变成全球创新的共同基础。
Linux、Apache和MySQL降低了互联网创业的基础成本;Hadoop、Spark、容器和Kubernetes则把分布式计算与云原生能力带给更广泛的开发者和企业。TensorFlow、PyTorch和Hugging Face又降低了AI研发、协作和模型使用的门槛。
这些技术的开放程度并不相同:有的是开放标准,有的是开放源代码,有的是开放接口,有的是开放权重。不能把它们简单等同。但共同之处在于,开放降低了参与生态的协调成本,让更多人能够在同一个基础上继续建设。
封闭系统可以创造优秀产品;但让一项技术走出一家企业、扩散到整个社会的,往往是开放的接口和生态。
开放权重究竟开放了什么?
《Open Weights and American AI Leadership》指出,一个国家的AI领导力不应只由某一个最强的前沿模型决定,更取决于能否建立强大、开放并可扩散到各行业的AI生态。
开放权重确实可以推动这种扩散。企业不必从零训练每个模型;开发者可以根据任务进行微调、量化和优化;受监管机构可以在自己的环境中控制数据;用户也不必把所有知识、流程和能力锁定在单一API供应商之中。
更重要的是,它让企业有机会为每项任务选择合适的模型,而不是为每项任务都调用最昂贵、最强大的模型:真正的前沿问题使用前沿模型,日常任务则使用更小、更快、更专业化的模型。
这可能是AI走向数十亿日常任务的可持续路径。但开放权重首先解决的是模型的“可获得性”,还没有完全解决Token的“可负担性”,更没有自动解决算力基础设施的“可部署性”。
每月158.20加元,两天内逼近单项使用限制
我是Claude的Max等级用户,每月订阅费用为CA$158.20。
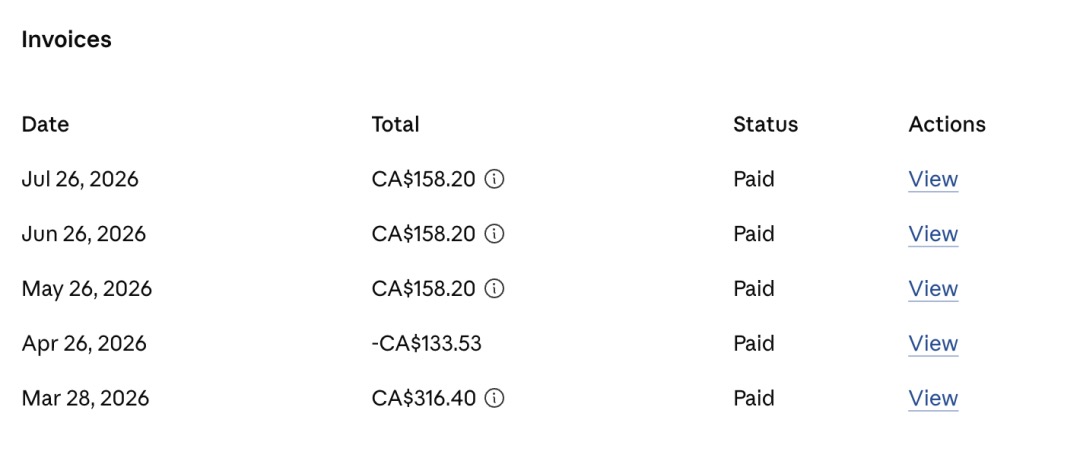
图2|作者的Claude账单页面:最近连续三个月的月度账单金额均为CA$158.20。
在一次高强度使用开始约两天后,额度页面显示:All models已使用59%,页面分类标签“Fable”已使用93%(提示栏显示“Fable 5”),已经逼近该单项的每周使用限制。
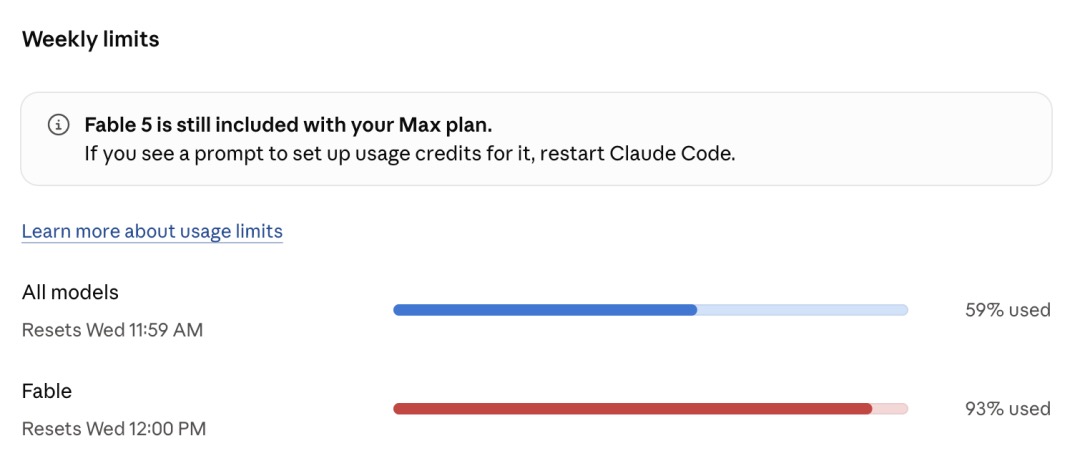
图3|高强度使用约两天后的额度页面:All models为59%,Fable为93%;页面提示栏显示“Fable 5”。
这并不意味着Claude不是一个好产品。恰恰相反,我愿意持续付费,是因为它已经成为有价值的生产力工具。这也不是对套餐的完整评测:具体消耗会受到模型选择、上下文长度、推理强度、Agent任务和系统规则等因素影响。
但它揭示了一个更基本的经济现实:AI看起来是一种软件服务,背后却仍然是一种受到稀缺物理资源约束的计量型产品。即使每月支付超过150加元,一个重度用户仍然必须关注额度、模型选择和使用方式。这对个人专业用户如此,对需要把数百万次AI调用嵌入产品的创业公司更是如此。
创业者寻找的不是最强模型,而是最便宜的“够用模型”
在最近接触到的美国创业者和AI产品讨论中,我越来越明显地感受到一种变化:很多团队不再只问“哪个模型最强”,而是问“对于这个任务,哪个模型能够以最低成本可靠完成”。
这不是技术理想的下降,而是AI进入商业运行后的必然成熟。越来越多的系统开始采用模型路由:
- 复杂推理交给前沿模型,分类、抽取和简单生成交给小模型;
- 重复请求通过缓存处理,长上下文被压缩;
- 专业任务使用经过微调、量化或蒸馏的模型;
- 当利用率足够高时,自行部署开放权重模型。开放权重因此增加了一种真正重要的商业选择:企业可以购买、调用、路由,也可以自行部署。但自行部署并不是免费午餐。API账单可能会转化为GPU采购、工程团队、电力、冷却、网络、运维和可靠性责任。
开放权重没有消灭成本。它改变的是谁承担成本、成本在哪里出现,以及企业是否有能力控制它。
Token是软件单位,也是一张物理资源收据
在用户界面中,Token看起来只是文字长度或API计费单位。但从经济意义上看,每一个Token背后都对应着对物理基础设施的一次调用:
- 加速器计算时间和高带宽内存;
- 芯片之间的网络通信、存储与数据传输;
- 电力供应;
- 热量排放与冷却系统容量。Token看起来是一个软件单位,本质上却是对物理基础设施的一次计量调用。
A token may look like a software unit. Economically, it is a metered claim on physical infrastructure.
这也解释了为什么模型不断开放,Token价格却不会自动归零。模型研发者可以发布权重,但无法通过一次下载复制GPU工厂、电网容量、变电站、液冷系统和数据中心。
你可以下载模型,却无法下载一个兆瓦
联署信提出,应当让AI扩散到制造业、医疗、农业、教育和更多日常商业场景。我认同这个方向。但“AI扩散”表面上是一个软件命题,最终却会变成一个物理基础设施命题。
一个组织可以在几分钟内下载模型,却不能在几分钟内获得:
- 一个兆瓦的稳定电力;
- 能够承载高密度GPU的机房;
- 一套液冷与热排放系统;
- 一座变电站;
- 完成集成、调试和长期运维的团队;
- 一个可以持续接纳热量的去处。你可以在几分钟内下载模型,却无法下载一个兆瓦、一套冷却系统,或者一个让热量去往的地方。
You can download the model in minutes. You cannot download the megawatt, the cooling system, or a place for the heat to go.
开放权重没有消除AI的瓶颈。它在一定程度上把瓶颈从模型层推向算力层,再从算力层推向兆瓦、电网和冷却系统。
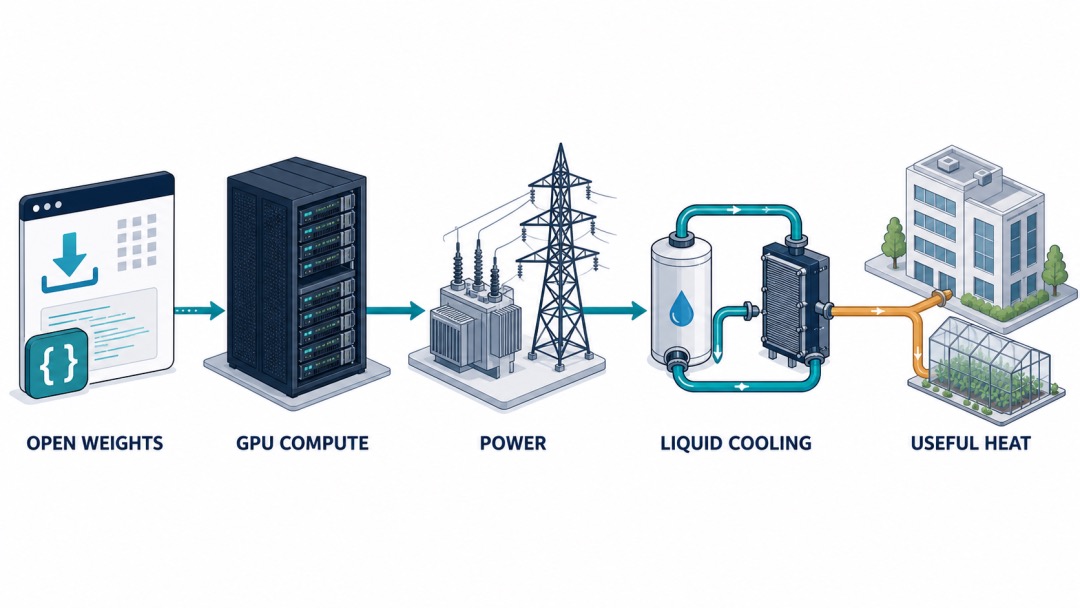
图4|开放权重可以下载,但GPU算力、电力、液冷系统及余热去向仍需在物理世界中建设。
从模型主权,到基础设施主权
拥有权重很重要:它意味着组织能够检查、修改和部署模型,也可以减少对单一平台的依赖。但拥有模型文件,不等于拥有持续运行模型的能力。
真正的AI控制权至少包括:
- 能否获得和修改模型;
- 能否控制自己的数据;
- 能否决定模型在哪里运行;
- 能否承担长期推理和后训练成本;
- 能否获得必要的算力与能源;
- 能否可靠地为设备供电并排出热量。拥有模型权重却没有运行它的能力,并不构成完整的AI主权。它只是软件层面的权利,而不是物理层面的能力。
分布式AI需要的不是缩小版超大数据中心
开放权重可能使AI部署更加分布式。超大规模训练集群不会消失,但我们会看到更多企业私有AI集群、受监管行业部署、区域性AI工厂、制造现场专业模型,以及靠近数据源的推理基础设施。
这些环境通常不能简单复制超大规模云服务商(hyperscaler)的基础设施模式。医院地下室、工厂机房和区域性数据中心,不可能都建设一套缩小版的超大规模冷冻水系统。它们受到空间、电力、用水、施工周期和运维能力限制。
因此,AI基础设施需要新的交付方式:
- 更小规模、可重复复制的模块化系统;
- 工厂预制、集成和验收测试;
- 闭式循环并尽量减少现场用水;
- 电力、液冷与控制系统协同设计;
- 适配不同芯片和服务器平台;
- 使用更少的现场接口,并在交付前完成更多调试。AI设备的形态在变化,部署模式也必须随之改变。
物理层不只是约束,也可以创造价值
AI基础设施讨论经常把电力与热量看成负担。但如果系统从一开始就围绕合适的回水温度和热量去向设计,数据中心排出的热可以服务于建筑供暖、生活热水、温室和低温工业过程;在合适条件下,还可以驱动吸收式制冷等系统。
在医院、工厂或农业环境中,AI算力可能不只是新的用电负荷,也可能成为本地能源系统的一部分。当然,并不是每个项目都具备经济可行的余热利用条件;热源温度、距离、季节性、负荷匹配和商业责任都必须经过工程评估。
只有当系统没有为热量设计下一站时,热量才是废热。
25年IT与6年液冷,让我看到同一个规律
从2001年进入IT行业至今,25年的软件、互联网和基础设施经历让我看到:软件依靠开放接口扩散。最近八年多在高密度算力中心基础设施领域的实践则让我看到:基础设施只有通过经过工程化的接口,才能规模化交付;其中,自2020年起,我进一步聚焦于液冷领域。
软件世界追求兼容、可移植、可组合和避免锁定;物理世界面对的则是供回液温度、流量与压降、快速接头、CDU与分配歧管、电力接口、控制逻辑、工厂验收测试、现场调试和长期责任边界。
开放不能只停留在模型层。如果AI真正要进入每一个行业,我们还需要可互操作的机架级架构、更标准化的液冷接口、可复制的预制基础设施、更透明的电力和水资源核算,以及清晰的系统集成与服务责任。
开放权重决定谁可以参与模型创新;基础设施决定这些创新最终能在哪里运行。
开放权重是起点,不是终点
开源软件时代告诉我们:当更多人能够参与建设,创新就会加速。开放权重也可能为AI带来同样的力量。它能够扩大选择、促进竞争、降低模型锁定,并让更多组织拥有自己的AI能力。
但这一次,软件不再运行在办公桌下的闲置服务器上。它运行在以兆瓦计量的基础设施上,需要机架级冷却、高密度供电和高速网络,并受到电网、水资源、土地和社区承载能力的共同约束。
开放权重解决的是AI普惠的第一道门槛,而不是最后一道门槛。如果希望AI真正进入工厂、医院、农场、学校和普通企业,就必须同时解决模型的可获得性、Token的可负担性以及算力基础设施的可部署性。
模型可以开放,Token仍在计量,而每一个兆瓦仍然需要被真正建设出来。
The model may be open. The tokens are still metered. And the megawatts still have to be built.
作者李俊明:清链科技副总裁,专注 AI 算力基础设施的电力、冷却与热能再利用,致力于让新一代 AI 数据中心超越单点设备优化,走向电力、液冷与热回收协同的一体化系统设计。
参考材料
·《Open Weights and American AI Leadership》,2026年7月24日,Microsoft官方页面(同文亦见NVIDIA官方PDF)。
·IBM History:《The IBM PC》。
·CERN:《The Birth of the Web》;1993年4月30日将Web软件置于公共领域,后续以开放许可证发布。
·Kubernetes Blog:《10 Years of Kubernetes》。
·Anthropic Help Center:Claude Max方案为每月100美元和200美元两档(用于核对套餐背景;CA$158.20以作者账单为准)。
·作者LinkedIn评论、Claude账单与额度页面截图,2026年7月。
作者:李俊明(Jim Li),清链科技联合创始人兼副总裁,NextGenergy 创始人兼 CEO。首发于微信公众号「清链学堂在线」,原文链接。转载请注明出处。 Markdown 版本