这不只是一台新机柜,而是一次AI基础设施产业角色的重构
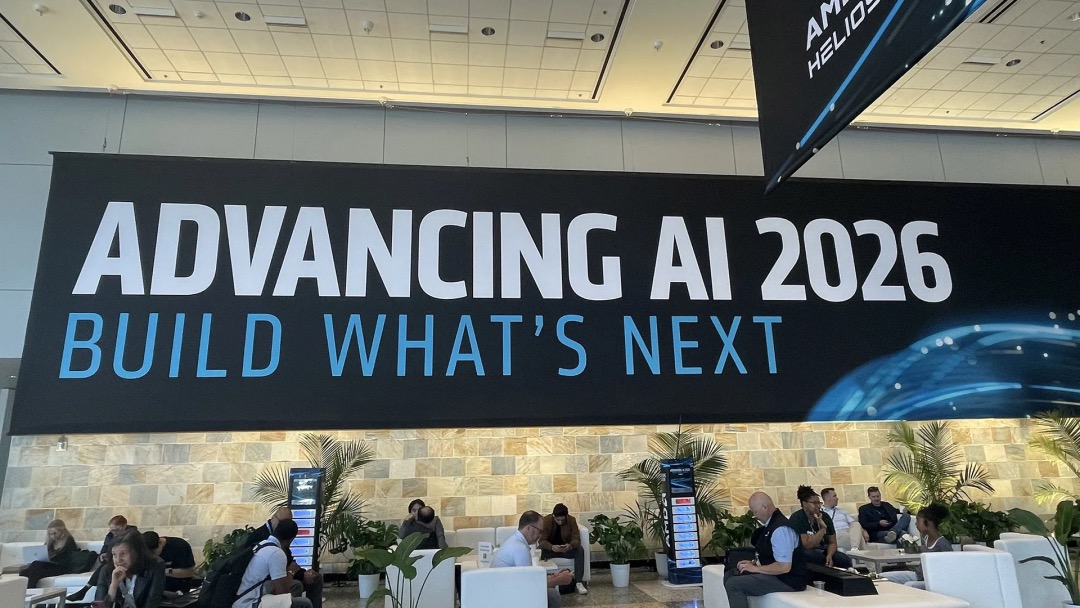
AMD Advancing AI 2026活动现场,旧金山
7月22日,我来到旧金山,参加为期两天的AMD Advancing AI 2026。活动期间,我近距离观察了现场展示的Helios机柜级系统,其中包括Wiwynn基于Helios架构开发的设备,也聆听了多位AMD技术专家对计算架构、GPU互连、网络、内存和系统设计的剖析。
站在这些设备前,我最直观的感受不是“AMD又发布了一款性能更高的GPU”。真正值得关注的是,AMD正在把CPU、GPU、网络、软件、供电、液冷和机柜设计,组织成一个共同优化的计算系统。
这与过去围绕单颗芯片展开的竞争,已经不在同一个层面。
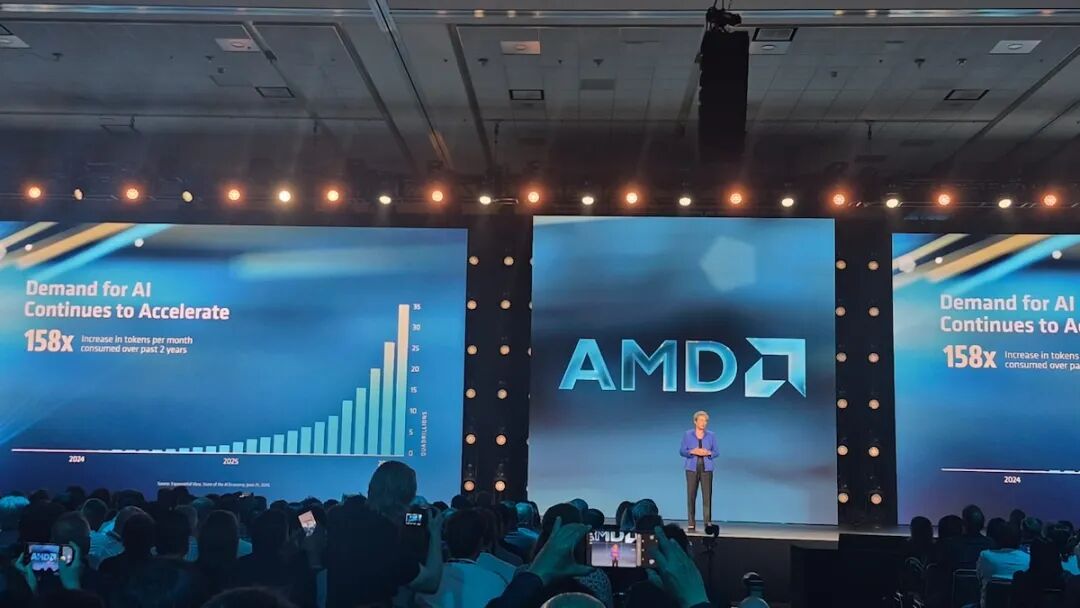
AMD董事长兼CEO Lisa Su在Advancing AI 2026发表主题演讲
Helios释放出的三个信号
表面上看,Helios是一套新的高密度AI机柜级平台。但如果只讨论算力、显存和带宽,就会低估它。
- 产品层面:AMD把AI产品的边界从单颗芯片和服务器节点扩展到了整个机柜。
- 公司层面:AMD正在从以芯片和节点级平台为核心的供应商,进一步走向机柜级AI架构的定义者和生态组织者。
- 行业层面:AMD试图在NVIDIA垂直整合体系之外,建立一条基于开放标准、多厂商参与的机柜级AI基础设施路线。
第一层:AI产品的基本单位正在从GPU变成机柜
过去讨论AI硬件时,人们习惯比较单颗GPU:算力、显存、带宽和功耗。但在前沿模型训练和大规模推理中,单颗GPU已经不能独立决定系统表现。
真正重要的,是数十颗GPU能否作为一个整体高效运行:GPU之间如何进行机柜内扩展(scale-up)互连,数据如何在机柜内部移动,CPU、GPU和网络如何协同,多个机柜如何实现跨机柜扩展(scale-out),以及供电、液冷和可维护性是否从产品定义阶段就被纳入架构。
Helios针对的正是这一整组问题。
AMD当前公布的标准Helios参考设计集成72颗AMD Instinct MI455X GPU、6th Gen AMD EPYC “Venice” CPU、AMD Pensando “Vulcano”网络和ROCm软件。每颗MI455X配备432GB HBM4,整柜合计约31TB;整套系统的峰值理论性能最高为2.9 ExaFLOPS FP4和1.4 ExaFLOPS FP8。
四套scale-up cartridges通过UALink over Ethernet(UALoE)连接机柜内GPU,AMD公布的总scale-up带宽最高为260TB/s;基于Pensando的scale-out网络带宽最高为43TB/s。以上均为AMD公布的峰值或理论规格,并不等同于具体模型或生产环境中的实际性能。
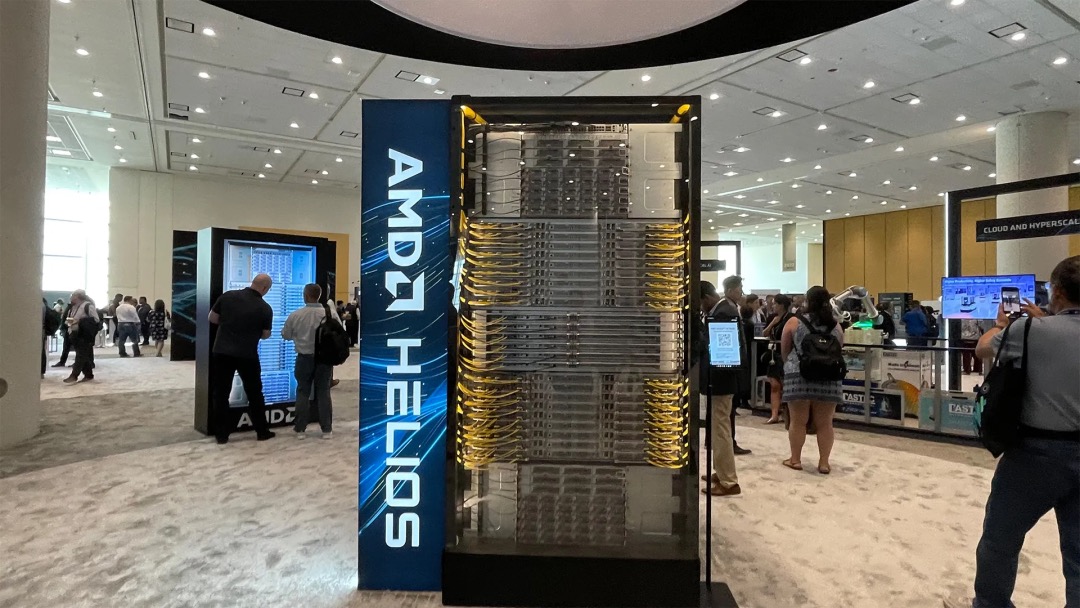
AMD Helios机柜级系统在Advancing AI 2026现场展出
这些规格说明,Helios并不是简单地把72颗GPU装进一个机柜。它把计算、内存、互连、网络、软件、供电、液冷和可维护性作为一个共同设计的系统。
从这个意义上说,Helios虽然在物理形态上是一个机柜,但在计算架构上更接近一台数据中心规模的计算机。
还需要特别说明:Helios不是AMD直接出售的一台标准整机。AMD官方将其定义为首个机柜级AI参考设计,由OEM和ODM合作伙伴据此开发、制造和交付各自的系统。AMD希望定义核心架构与关键接口,同时通过合作伙伴完成网络设备、系统制造、客户适配和规模部署。
第二层:AMD不是第一次做平台,但这是它第一次把平台推进到整个机柜
如果把AMD过去的角色简单概括为“只卖CPU和GPU”,并不准确。
在Helios之前,AMD已经进行了多年的系统级布局:EPYC进入云计算、企业服务器和高性能计算市场;Instinct MI250X参与Frontier等超级计算机;2023年的MI300X Platform已经把8颗GPU整合进基于OCP标准的节点级平台;ROCm长期承担AMD的AI软件生态;2022年收购Pensando后,AMD又补充了DPU、网络和基础设施软件能力;Xilinx则带来了FPGA、自适应SoC和相关软件技术。
所以,Helios不是AMD突然从“芯片公司”变成“系统公司”。更准确的发展路径是:AMD正在从CPU和GPU供应商,走向节点级平台供应商,再进一步成为机柜级AI架构的定义者和生态组织者。
其中一个关键动作,是AMD在2025年完成对ZT Systems的收购。ZT Systems拥有面向超大规模客户的机柜级系统设计、验证和客户导入经验。AMD随后保留其系统设计、客户使能与客户导入能力,并剥离制造业务。这表明AMD希望掌握系统架构、设计验证和客户协同,而不是把自己变成一家传统服务器制造商。
AMD不再只希望自己的芯片被安装进别人定义的AI系统,而是开始参与定义整个AI系统应该如何构建。
第三层:AMD正在建立一条开放的机柜级AI路线
NVIDIA在AI市场上的优势从来不只来自GPU,而是来自GPU、NVLink、网络、CUDA、系统架构和机柜级产品共同组成的完整体系。客户购买的不是一颗孤立芯片,而是一套能够快速部署、稳定运行的软件和硬件平台。
Helios试图在这一层面建立AMD的回答。它采用Meta提交给Open Compute Project的Open Rack Wide(ORW)机柜标准,并结合UALink、UALoE以及以太网scale-out网络,在NVIDIA垂直整合体系之外构建一个多厂商参与的开放架构。
这里的“开放”不仅是技术标准,也是一种产业组织方式:AMD定义CPU、GPU、网络和参考架构;大型客户参与标准和工作负载优化;Celestica参与scale-up交换机研发和制造;Sanmina、Wiwynn、Wistron和Inventec等厂商参与系统制造;HPE等OEM把参考架构转化为面向客户的产品。
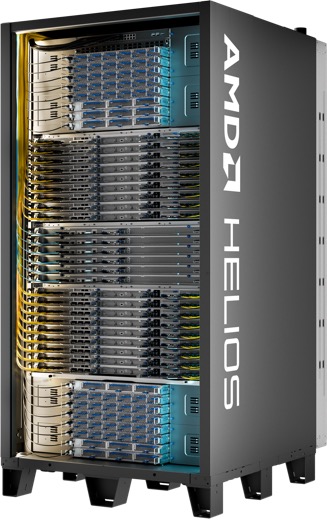
AMD Helios机柜级参考设计。图片来源:AMD
从技术发布走向吉瓦级商业承诺
开放架构只有在形成商业规模后,才可能真正影响市场。
OpenAI和Meta已分别与AMD达成最高6GW的多年度、多代产品合作;Anthropic计划部署最高2GW的AMD Instinct MI450系列GPU;Oracle计划从2026年第三季度开始部署首批5万颗MI450系列GPU。
这些数字不能理解为全部容量已经交付,也不能推断所有部署都采用完全相同的MI455X标准Helios配置。Meta首批部署采用面向其工作负载定制的MI450架构GPU;其他公告多数使用更宽泛的“MI450 Series”表述。
但这些合作至少说明,Helios已经不再只是一套实验性参考设计,而正在成为AMD进入大规模AI基础设施市场的核心载体。
Helios可能重新划分产业链中的价值和责任
如果Helios成功实现规模化部署,它带来的变化将不只发生在GPU市场,还可能重新划分服务器厂商、网络厂商、液冷企业、配电厂商、系统集成商和数据中心运营方之间的责任边界。
当AI机柜进入200kW以上的功率等级,供电和液冷不可能再等到服务器选型结束后才单独设计。机柜结构、楼板承重、母线、冷却液分配装置(CDU)、分配歧管(manifold)、快速接头(quick disconnect)、供回液温度、流量、压降、残余风冷负荷、漏液检测和控制接口,都需要在平台定义阶段共同考虑。
数据中心基础设施不再只是被动承载计算设备的建筑,而正在成为计算产品本身的一部分。
服务器厂商的价值也将从设备制造和装配,进一步转向系统验证、工厂验收测试(FAT)、现场调试(commissioning)、质保整合和全生命周期服务。
对于液冷和电力基础设施企业而言,未来的机会不再只是出售一套CDU、一组冷板或一套配电设备,而是更早进入AI平台的设计和交付体系。
从清链科技的视角:液冷正在进入计算平台的核心定义
清链科技已经在液冷领域持续耕耘六年。
这些年,我们看到液冷从少数高性能计算项目中的特殊需求,逐渐发展成高密度AI数据中心的基础条件。但Helios所代表的变化,比“越来越多的服务器开始采用液冷”更深一层。
在200kW以上的机柜功率等级中,冷却不再是一套在服务器设计完成后附加上去的设备。它开始直接影响GPU布局、机柜尺寸、供电架构、网络连接、设备维护方式,以及整个数据中心的设计边界。
液冷不再只是解决芯片散热问题,而是开始参与定义下一代AI计算平台。
这也是清链科技对AMD此次动作最期待的地方。我们关注的不只是哪一种GPU最终获得更多市场份额,而是开放的机柜级架构能否推动计算平台厂商、服务器厂商、液冷企业和数据中心运营方更早协同,建立清晰、可复制的技术接口与交付边界。
如果这种协同能够形成,液冷行业的价值将不再局限于CDU、冷板和管路设备,而会进一步延伸到数据中心场地就绪(site readiness)、机柜到现场的液冷接口、预制化供配电与冷却模块、工厂验收测试(FAT)和现场调试(commissioning)、运行维护、系统可用性、温水运行和余热利用。
对于清链科技而言,这既意味着长期坚持的技术方向正在得到验证,也意味着更大的责任:我们需要把多年积累的液冷经验,转化为支持下一代AI平台快速、可靠落地的工程与交付能力。
开放带来选择,也带来新的集成挑战
Helios最有吸引力的叙事之一是开放。但开放并不自动等于简单。
垂直整合体系的优势,是系统责任相对集中;开放体系的挑战,则是多个厂商必须真正实现互操作,并明确谁对最终性能、可靠性和服务负责。
因此,Helios能否真正改变行业,不仅取决于MI455X的性能,还取决于ROCm能否继续缩小软件生态差距,UALink和UALoE能否在大规模生产环境中证明稳定性,OEM和ODM能否保证一致的系统质量,液冷、电力和控制接口能否实现有效标准化,以及多厂商体系能否建立清晰的质保与服务边界。
如果这些问题得到解决,Helios可能成为开放AI基础设施第一个真正实现规模化的机柜级样板;如果解决不了,它也可能成为一套参数强大、但集成复杂度过高的参考架构。
真正的结论
离开AMD Advancing AI 2026会场后,我反复思考的并不是Helios的某一项性能数字,而是AI基础设施的竞争单位已经发生变化。
AMD并不是第一次提供计算平台,也不能简单地说它从芯片公司突然变成了基础设施公司。更准确地说,它正在把多年积累的CPU、GPU、网络、软件和系统设计能力,第一次整合成完整的机柜级AI参考架构。
对AMD而言,这是从芯片和节点级平台供应商,走向机柜级架构定义者的一次关键升级。对大型AI客户而言,这是在NVIDIA之外建立一条更完整、更开放的机柜级计算路线的机会。对NextGenergy这样的液冷和数据中心基础设施参与者而言,它意味着液冷、电力、现场集成和余热利用将更早进入计算平台的产品定义,而不再只是项目后端的配套工作。
六年来,我们一直在研究如何安全、高效地把热量从芯片带走。但Helios让我更加确信,下一阶段的问题已经不只是“如何冷却一台服务器”,而是如何让计算、供电、液冷和数据中心从第一天起,就被设计成同一个系统。
Helios目前还没有完成行业洗牌。但它已经把竞争推进到了一个更高的层面:未来的AI基础设施由谁定义、由谁集成、由谁交付,又由谁对最终运行结果负责?
这才是我在AMD Advancing AI 2026现场看到的真正变化。
—— 李俊明,清链科技副总裁。为 AI 数据中心做供电、冷却与热回收的一体化设计。
主要资料来源
- AMD Helios官方产品与架构说明
- AMD Advancing AI 2026
- AMD完成收购ZT Systems
- AMD与OpenAI的最高6GW合作
- AMD与Meta的最高6GW合作
- AMD与Anthropic的最高2GW合作
- AMD与Oracle的Helios合作
- AMD与Celestica的Helios scale-up交换机合作
作者:李俊明(Jim Li),清链科技联合创始人兼副总裁,NextGenergy 创始人兼 CEO。首发于微信公众号「清链学堂在线」,原文链接。转载请注明出处。 Markdown 版本