昨天 Dario Amodei 发文,说前沿实验室必须主动放慢能力推进的速度,好让安全工作跟上。同时他承诺,Anthropic 将让第三方评估人员进驻公司,权限比照内部员工。Sam Altman 随后表态支持,说 OpenAI 也这么做。马斯克也附议了。
三个死对头,一天之内站到了同一个立场上。这不是寻常的一周。
但这还不等于谁答应停下模型研发——Amodei 自己在文里说得很清楚,定速不是停训。
对齐问题我没有发言权,也不打算装作有。但他方案里的第一步,我们这行的人一眼就该认出来。
先说利益关系:我做的是液冷和余热回收的生意。下面第三节,请带着这个前提读。
实验室刚刚发明的东西,我们这行叫监理
Amodei 方案的第一步,是让外部评估人员进到公司里面办公——有工位、有工牌、发电脑,用的工具跟内部风险团队一样,并且合同要保证他们能自主发布看到的结论。
这套东西,数据中心行业几十年前就有了,叫独立第三方调试,叫第三方见证的联合调试,叫认证机构的现场performance demonstration。
形式当然不完全一样。评估员是常驻的、有发布权的,调试顾问的范围、周期和权限都更窄。但底下那句话是同一句:自己说自己没问题,不算证据。
所以,这套机制在压力下会怎么走样,没人需要猜。我们已经把这个实验做完了,也知道它在哪里失效:
- 评估方的合同和钱,来自被评估方。 这本身不必然让人不独立,但它决定了谁有权中止这段合作。
- 测试时机,会被安排在最容易通过的那一天。
- 临近移交才提出来的问题,会从“缺陷”降级成“建议”。
- 出在两家供应商交界处的故障,没人认。
所以真正该问的问题很窄,也很好答:评审方能不能写下一个不利的结论?这个结论能不能送到拍板的人手里?一个没关闭的问题,能不能真的把验收卡住?
独立性能活多久,取决于“让结论生效”的权力能活多久。 合同只是起点,权限、能力、汇报路径、执行力,才决定它撑不撑得住。
那么反过来:如果外部审视在实验室里是对的,它在供电、在循环冷却液、在把设备摁在工况范围内的那些系统上,同样是对的。
我的主张是,AI 算力的交付,应该内建三件事:把电用明白、把故障工况验出来、把故障关在局部。
一、“把电用明白”正在变成一个交付问题,不是道德问题
先讲生意,再讲道理。
今年 7 月,QTS 宣布终止弗吉尼亚 Prince William County 的 Digital Gateway 项目,撤回相关申报,此前这个项目陷在一场漫长的法律纠纷里。这是一个具体项目的个案,不能由此推出“资本不重要”。但它确实说明,规划审批和诉讼能把一个项目停在原地。
几天前,Brookfield 和 Bloom Energy 把 AI 电力项目的融资框架从 50 亿美元扩到 250 亿。注意,那是融资框架,不代表钱已经投下去了。
两件事放在一起,能得出一个不大但要紧的结论:有钱,不等于有建的资格。
加拿大那边已经把话挑明了。联邦《负责任数据中心开发原则》要求签署方做余热回收,并提供可被独立核验的本地影响信息。今年 8 月,Oakville 成为安省第一个、也是目前唯一一个真正落地暂停令的市镇,通过了为期一年的临时管制条例;Mississauga 议会已指示起草同类条例,9 月 16 日才上会——这两者处在不同阶段。另一边,Burlington 和 Hamilton 的暂停动议被否决了,Sault Ste. Marie 的动议在表决前撤回。新不伦瑞克的框架征询到 10 月 2 日。
所以不是各地在关门。是门后面多了一道问题。
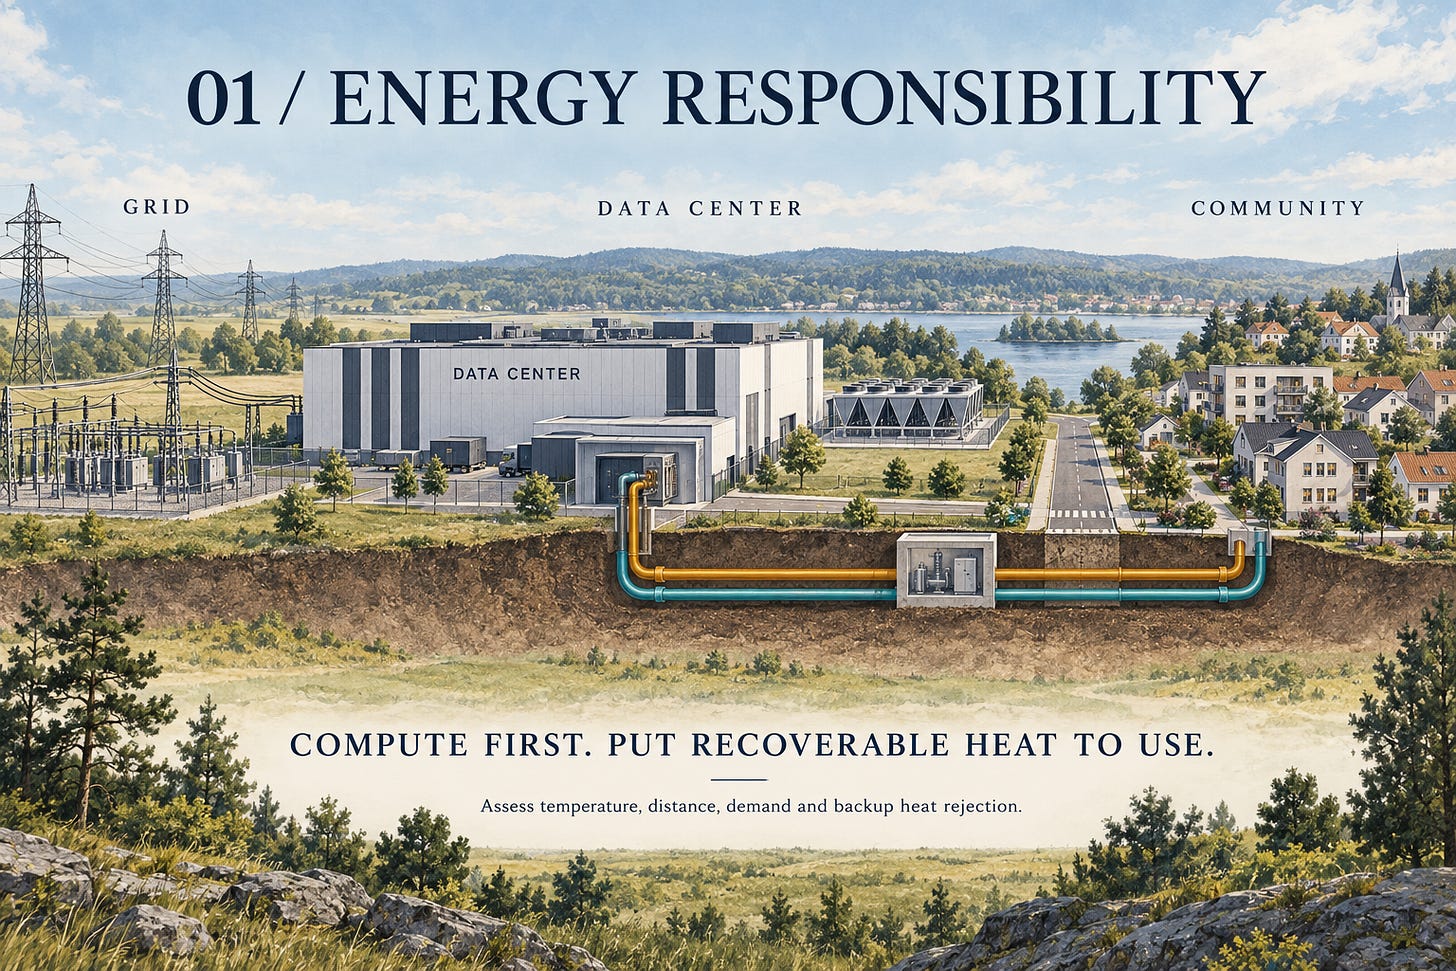
于是设计阶段真正该算的,是这个站点每一度电换回来了什么:算力的转化效率如何,冷却系统吃掉多少,以及——回收出来的热,有没有一个真实的去处。
余热回收能把这笔账往上抬一层。微软在丹麦 Høje-Taastrup 的项目,就是把数据中心接进了当地的区域供热网。但前提是得有一个真的要热的客户。温度对不对得上、距离多远、季节性需求怎么波动、接入这笔钱谁出,每一项都能把方案否掉。如果中间还要靠热泵把温度提上去,热泵那部分电耗也得算进总账——微软自己的示意图里就画了这一步。
这些事要趁早算,趁选址和冷却架构还没定死的时候。等这两件事硬化了再回头找热的出口,能选的路就没几条了。
还有一个不好听的问题必须有答案:热用户不收热的那天,怎么办? 站点必须有一条经过验证的排热通路。余热回收是给社区创造价值的,不能反过来变成算力运行的一个不可控依赖。
顺便说说我们自己发出去的那些数字
这里有一个坑,是我自己踩过的,也是最可能让上面这一整套主张失去说服力的地方。
今年早些时候,我在《From 25 Tonnes a Day to Zero》里发过一个冷却塔的用水数字。后来我像审稿人那样回头核了一遍。我以为会发现算错了。没有。这更糟。
按一组假设推回去,浓缩倍数大约是 3.7——一个再正常不过的数。可只要把假设稍微动一动:潜热取塔的实际工况温度而不是沸点、潜热占比从“全部”改成 85%、再按冷天气调一次——浓缩倍数就在 2.8 到 12.8 之间漂。
这是敏感性计算,不是实测值。但它也不是误差棒。落在这个区间两端的,是两套完全不同的水处理方案:一头在拼命排污、追着自己从没控住的水质跑;另一头有软化水、有正经的加药程序、有一个知道电导率设定值该调到多少的操作员。同样的补水量,同样的名义负载,同样的一句话出现在我的文章里。
那个数字从头到尾没被证明是错的。缺的是边界。 我没说清楚负载指的是铭牌、峰值还是日均,没说清楚那块水表覆盖了哪几路水,也没说清楚读数取的是哪一段时间。
一个怎么讲都说得通的数字,等于什么都没说。
我们既然要求实验室给出可核验的结论,自己发出去的能耗和水耗数字,就得把测量边界、运行工况和证据一起带上,还要有人署名。一个能跟故事对上的计算,代替不了一份缺失的运行记录。
二、安全从设计开始,但必须扛得住联调
急着把算力投运,这件事本身可以理解。危险的是,拿竣工日期去冒充已经验证过的运行就绪状态。
两起事故把这个区别讲得很清楚,而且细节比结论更有用。
2026 年 7 月,荷兰一处承载 Google Cloud 业务的设施,市电侧出现了一次三毫秒的电压跌落。冷机控制器在这个暂态里掉线,没能给冷冻水泵发出重启指令,泵停了,起不来。A 侧的 DRUPS 后备电源因元件故障,没有接管数据厅负载。厅内温度冲到 44°C,越过设备安全阈值,系统保护性停机。
报告里有一句话值得读两遍。它说,冗余电源”因该设施已知的在建工程而不可用“。
已知。在建。
也就是说,这个站点在带着生产负载运行,而它的冗余正因为一项尚未收尾的工程处于缺失状态。然后一个三毫秒的事件,精准地找到了这个缺口。
竣工日期和运行就绪之间的区别,运营方自己用一句话写清楚了。
2025 年 11 月,Azure 西欧的一起事故是同一个形状:电压骤降导致冷却机组停机,一个此前未知的硬件缺陷让它们无法自动重启。温度上升,存储单元断电保护,恢复花了大约九个半小时,其中存储完整性校验必须逐个串行执行,把时间进一步拉长。
这两份报告都没有证明是抢工期导致了事故。但它们说明了一件更有用的事:有冗余,不等于能恢复。
两个站点都有后备。一个是后备自己没接上负载,一个是设备起不来。只问“冗余单元在不在”的测试,两次都测不出来。
机柜级液冷让这种共用依赖更难被忽略。今年早些时候我站在 Wiwynn 做的 AMD Helios 实现前面,看的不是 GPU 数量,是机柜和建筑之间那条边界——具体说,是那根同时给算力托盘和交换托盘供冷的分水器。
**当交换网络也开始走液冷,冷却就不再是伺候算力的辅助设施,它变成了算力结构的一部分。**一次冷却故障,可以同时打掉 GPU 可用性和网络可用性。热设计已经进入可靠性设计的范畴,评审时必须回答:当一段冷却回路被隔离,哪些算力和网络功能还活着。
所以设计评审里该问的问题很具体:
在约定的夏季设计工况下,有一个关键冷却部件处于检修状态时,这个站点能稳定带住多少 IT 负载?
冷却液温度、室外排热能力、冗余配置,就是在这个问题上,把一个“宣布出来的容量数字”变成一个运行限值。
一个头条级的机柜功率密度,是设施的设计能力,不是完整的热规格。真正的规格是一整个运行包络:稳态负载、负载阶跃、冗余状态、流体温度、流量、压降,以及故障过程中的行为。
答案必须说清楚工况,说清楚考虑的是哪一种故障。多一台备用泵,回答不了“启动它所需的控制系统不可用时会怎样”。一次成功的电源切换,也证明不了冷却循环能在时间窗内恢复。
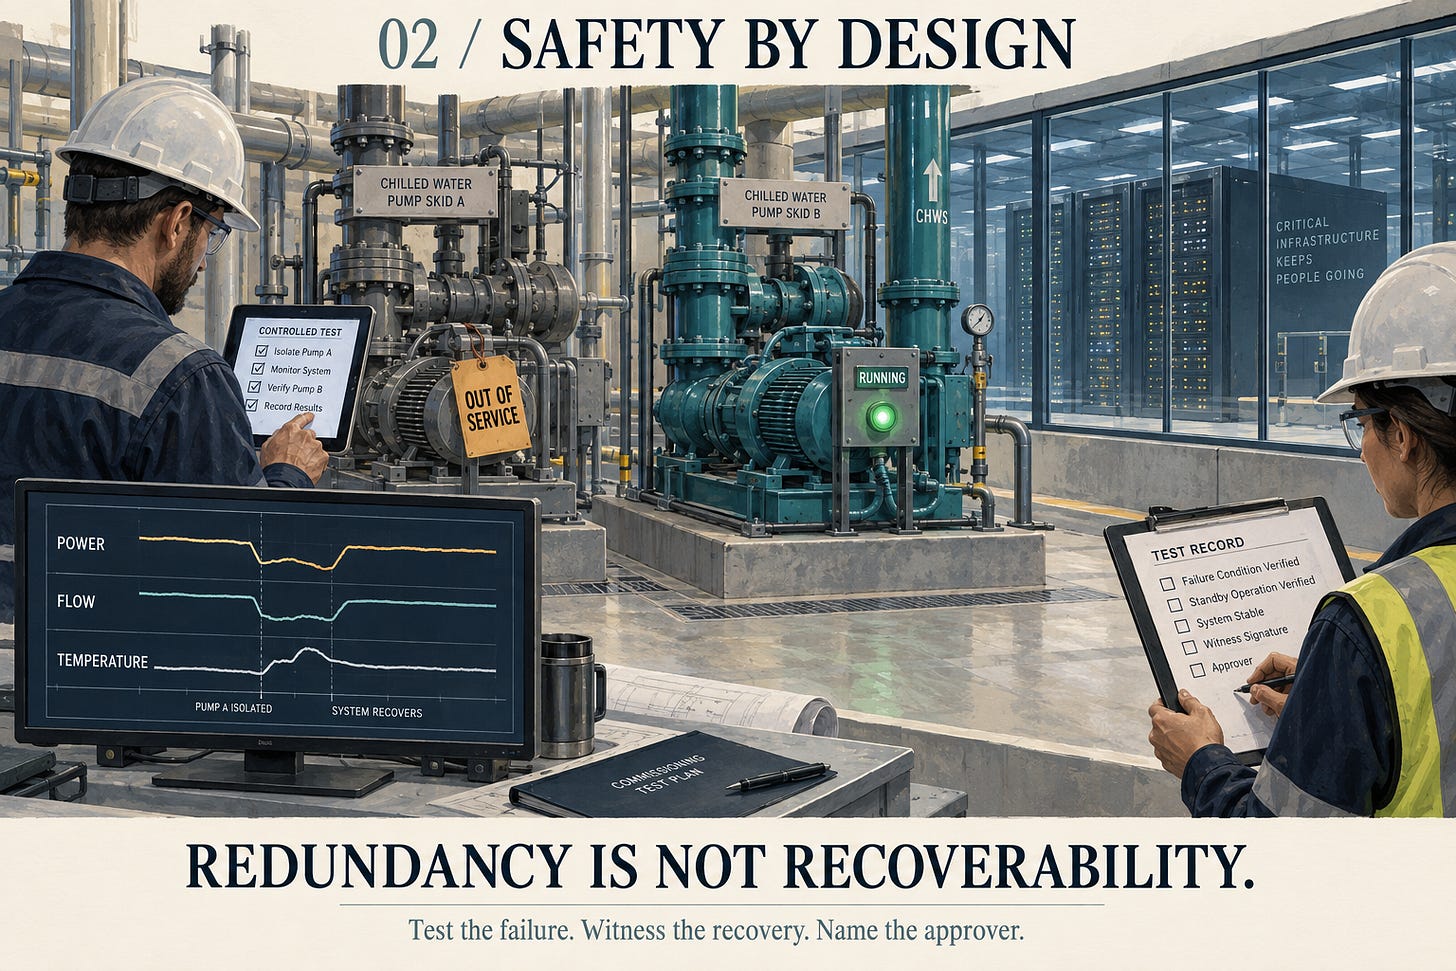
验收方案应该覆盖失电、重启行为、设备缺失状态、以及负载恢复的顺序。它还应该写明每一项测试由谁负责,以及两个设备包交界处出了问题,由谁裁决。
最后,它得有人签字。一份没有署名的验收记录,说明不了是谁点头让它投运的。 记录里要有:谁测的、在什么工况下测的、对照的是哪个标准或哪条项目约定、谁见证的,以及业主方哪位授权代表接受了这个结果和剩下的风险。签字不能替代证据。签字确立的是,谁为这份证据背书。
没有哪种设计能消除全部风险。该做的是:把可信的故障场景列出来,定义可接受的响应,并在设施承接对应 IT 负载之前,把它们逐条验过。
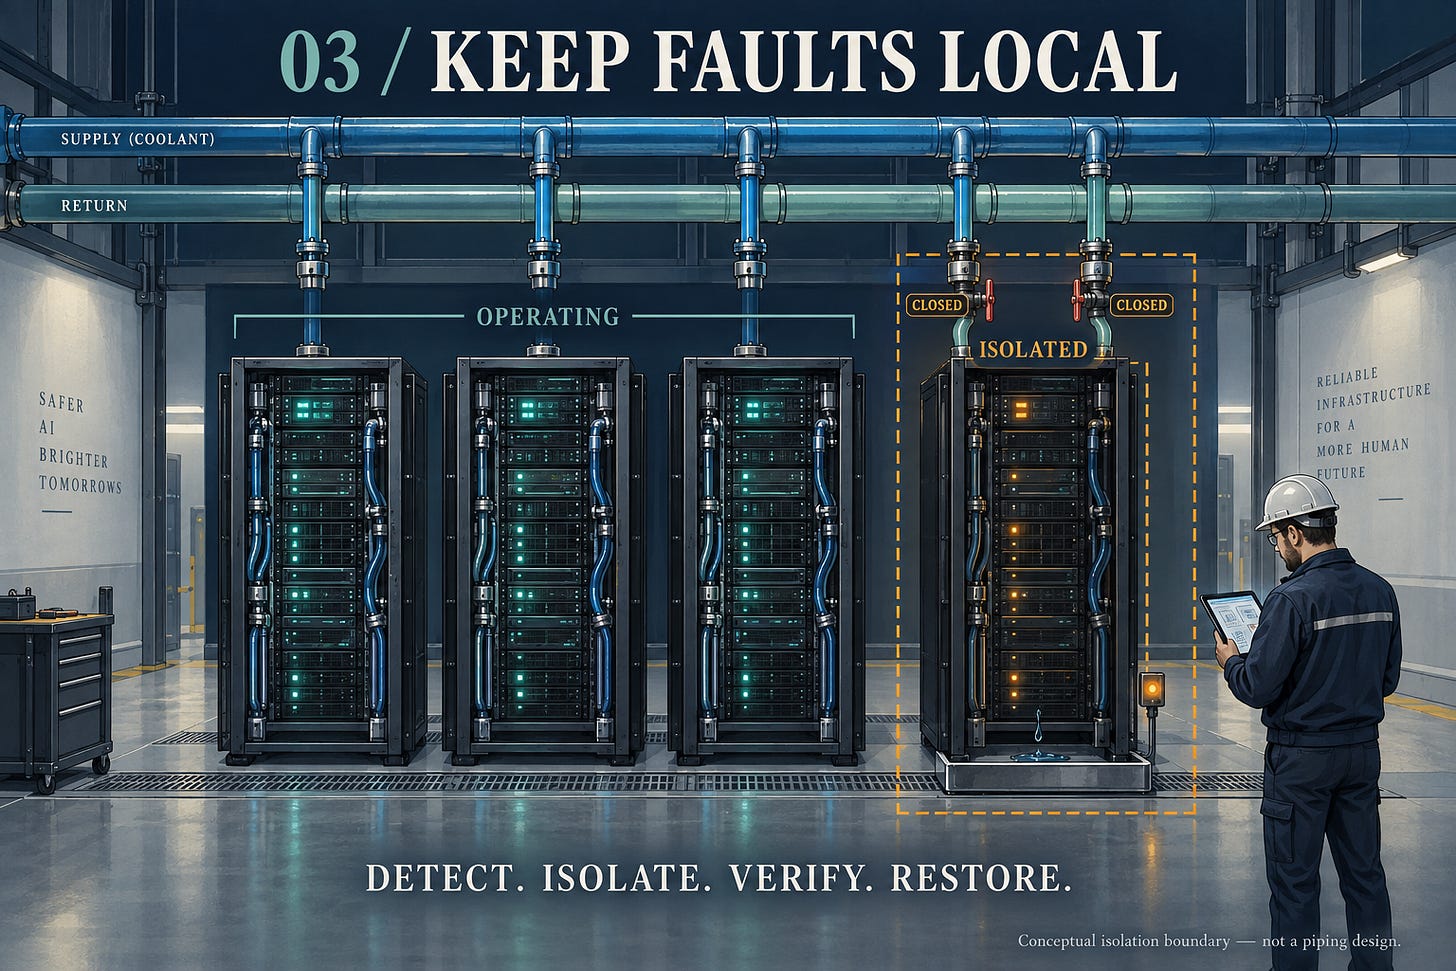
三、液冷运维的底线:把故障关在局部
液冷把 IT 设备串在共用的流体回路上,所以检修一台设备,必须同时考虑整个系统。风冷也有共用依赖,区别在于:检修液冷设备往往要断开一个流体接口,这就牵出隔离、防护和恢复三件事。
我的要求很简单:一处漏液,应该只是一次局部事件。
这是一个需要被验证的设计目标,不是一个可以默认成立的属性。具体怎么响应,取决于架构和故障位置;为了保设备,可能要停一台服务器、一个机柜,甚至更大的一段。
另外,别再把“漏液”当成一件事。它是一个词在干三份工作,三份工作的发现时点不同、解法不同、责任人也不同:
- 制造:焊缝、钎焊、压接和装配缺陷,本该在出厂前筛掉;
- 交付:运输、吊装、安装过程中造成的损伤;
- 服役:腐蚀、振动、热循环,以及维护动作本身带来的失效。
要说明的是,这是风险来源和管控阶段的划分,不是“保证在哪个时点被发现”——一个制造缺陷完全可能拖到服役期才暴露。每个阶段都需要自己的证据链和责任人。把三者当成一个问题,结果就是注意力和预算全压在中间,两头都薄。
两条纪律最吃重。
第一,先定验收判据,再选测试方法。 在没定下允许泄漏率之前就争论“用氦检还是压降”,是把一个工艺问题变成了采购问题。判据里要写清允许泄漏率、试验介质、压力、温度、持续时间和检测能力,并且受元器件限值和项目要求约束。
第二,测总成,不只测零件。 零件测试说明不了安装阶段现场做出来的那些连接。任何新做的或被拆动过的连接,恢复运行前都需要一套验证程序。还要分清楚:强度试验和密封性试验回答的是两个不同的问题,从通用规范里抄一个压力倍数,构不成一份完整的试验规格。
至于故障发生之后,OCP 的《Leak Detection and Intervention》白皮书把探测和干预当作两个相关的工程决策来处理,包括断电和流体隔离。检测到液体,只是响应的开始。
评审时我会问四个问题:
- 选定的传感器,能不能在真正要紧的位置检出实际使用的那种冷却液?
- 能被隔离的是哪一段?隔离之后,哪些没受影响的设备应该继续运行?
- 流体隔离、电气保护、冷却系统响应,这三者怎么协同?
- 凭哪些检查,可以授权这一段恢复运行?
这些答案必须落到运维手册里。在拔掉一台服务器之前,操作人员就该知道:自己正在打开哪一条边界,这一段怎么做到安全,以及重新接回去之前要查什么。
衡量韧性的实际标准只有一个:一次故障的后果——波及了什么,多快被控住,恢复要付出什么。
不必等前沿那边吵出结果
模型安全和基础设施安全,面对的是不同的危险,不该混为一谈。一个站点延期,买不来 AI 研究者要的那段评估时间。站点延期本身,既说明不了前沿能力推进有多快,也说明不了多出来的时间会不会被用在评估和对齐上。
但这场争论给了我们这行一个机会,把“什么叫负责任的交付”说清楚。
在我这里,它意味着:趁余热回收还能影响设计的时候把它算清楚,并且发出去的数字要带着边界;把故障响应在电和冷的交界处验出来,并且给结果签上名;把隔离边界定义出来,让安全检修在现场真的做得到。
实验室刚刚承认了一件事:建造方自己的话,不构成证据。这个原则不是他们发明的,也不该停在他们门口。
不必等到 AI 按下暂停键,我们才开始回收余热、验证故障响应、并且不让一处局部故障蔓延出去。
你在手上的项目里,最缺的是哪一项:余热回收、联合故障验证,还是液冷回路的隔离?
延伸阅读
- Dario Amodei 原文《We Must Pace the Frontier》:https://darioamodei.com/post/we-must-pace-the-frontier
- Google Cloud 荷兰 europe-west4 事故报告(2026 年 7 月 15–16 日):https://status.cloud.google.com/incidents/3BvH3LVGcupoYqV6F4Nw
- Azure 西欧事故复盘(2025 年 11 月 5–6 日,跟踪号 2LGD-9VG):https://azure.status.microsoft/status/history/?trackingId=2LGD-9VG
- OCP《Cold Plate Leak Detection and Intervention》白皮书:https://www.opencompute.org/documents/acs-cold-plate-leak-detection-and-intervention-white-paper-pdf-1
- 加拿大《负责任数据中心开发原则》:https://ised-isde.canada.ca/site/ised/en/canadas-responsible-data-centre-development-principles
本刊往期:
- 《Power Is the Real Ceiling》——QTS、Brookfield 与 Bloom,以及为什么最快的那一兆瓦是已经接好的那一兆瓦:https://everywattcounts.substack.com/p/power-is-the-real-ceiling-and-the
- 《From AMD Advancing AI 2026: Helios Is More Than a New Rack》——头条功率密度背后的运行包络:https://everywattcounts.substack.com/p/from-amd-advancing-ai-2026-helios
- 《The Biggest Risk in Liquid Cooling Is Not Whether It Leaks. It Is When.》——制造、交付、服役:三个窗口、三类责任人、三套证据:https://everywattcounts.substack.com/p/the-biggest-risk-in-liquid-cooling
- 《From 25 Tonnes a Day to Zero》——后来被我回头重核的那个水数字:https://everywattcounts.substack.com/p/from-25-tonnes-a-day-to-zero-the
作者:李俊明(Jim Li),清链科技联合创始人兼副总裁,NextGenergy 创始人兼 CEO。转载请注明出处。 Markdown 版本